Kokoro遇见Abogen:开源TTS的完美实践
通过abogen开源项目的成功实践,Kokoro-82M这个仅有8200万参数的轻量级TTS模型展现了如何以小博大,将先进的语音合成技术转化为真正解决用户需求的实用工具。

在AI语音合成领域,理论技术与实际应用之间往往存在着一道鸿沟。Kokoro-82M作为一个突破性的文本转语音模型,在abogen这个开源项目中找到了完美的应用场景,向我们展示了如何将先进的TTS技术转化为真正实用的工具。
Abogen:让Kokoro走向实用的桥梁
什么是Abogen?
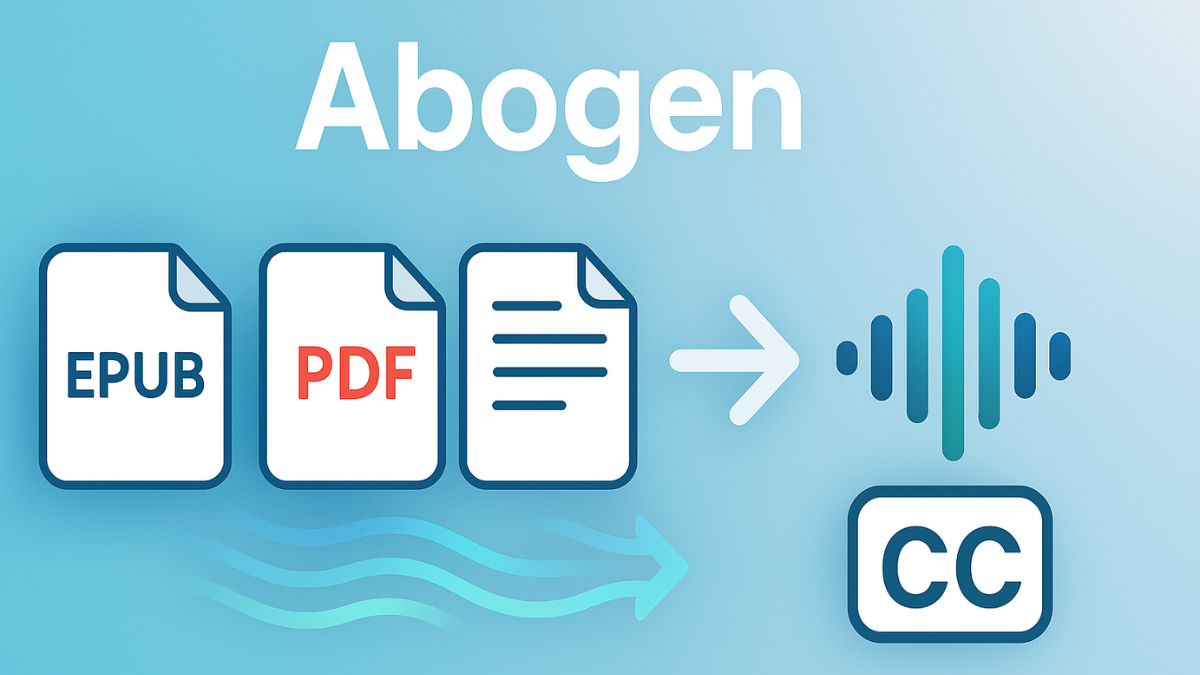
Abogen是一个功能强大的文本转语音转换工具,可以轻松将ePub、PDF或文本文件转换为高质量的音频,并配有匹配的字幕。这个开源项目的独特之处在于,它选择了Kokoro-82M作为其核心TTS引擎,将这个轻量级但性能卓越的模型的潜力完全释放出来。
为什么选择Kokoro-82M?
在众多TTS模型中,abogen选择Kokoro-82M并非偶然。这个选择背后有着深思熟虑的考量:
1. 性能与资源的平衡
- 轻量高效:8200万参数的紧凑设计,适合本地部署
- 质量保证:尽管参数量小,但生成的语音质量媲美大型模型
- 速度优势:在演示中,仅用5秒就生成了约1分钟的高质量音频
2. 开源生态的协同效应
- 许可兼容:Kokoro-82M采用Apache-2.0许可证,允许商业使用
- 社区支持:活跃的开发者社区为两个项目都提供了持续改进的动力
- 技术透明:完全开源的架构便于定制和优化
Kokoro在Abogen中的技术实现
核心架构集成
Abogen巧妙地将Kokoro-82M集成到了一个完整的音频书制作流程中:
# Abogen中Kokoro的典型使用流程
from models import build_model
import torch
from kokoro import generate

# 初始化模型
device = 'cuda' if torch.cuda.is_available() else 'cpu'
MODEL = build_model('kokoro-v0_19.pth', device)

# 生成语音
def generate_audio(text, voice_code):
    voicepack = torch.load(f'voices/{voice_code}.pt', weights_only=True).to(device)
    audio, phonemes = generate(MODEL, text, voicepack, lang=voice_code[0])
    return audio, phonemes
多语言支持的实现
Abogen充分利用了Kokoro的多语言能力,支持多种语言和地区方言:
- 🇺🇸 美式英语 ('a'): af, af_bella, af_sarah, am_adam, am_michael
- 🇬🇧 英式英语 ('b'): bf_emma, bf_isabella, bm_george, bm_lewis
- 🇪🇸 西班牙语 ('e'): 支持西班牙语音合成
- 🇫🇷 法语 ('f'): 支持法语fr-fr
- 🇮🇹 意大利语 ('i'): 意大利语支持
- 🇯🇵 日语 ('j'): 需要额外安装misaki[ja]
- 🇨🇳 中文 ('z'): 普通话支持,需要安装misaki[zh]
Abogen的核心功能特性
1. 文档格式支持
Abogen支持ePub、PDF和纯文本文件的直接转换,这使得用户可以:
- 电子书转换:将整本电子书转为有声书
- 文档朗读:将PDF文档转为音频,方便移动收听
- 文本处理:支持纯文本的批量语音合成
2. 智能字幕同步
Abogen能够生成与音频完美同步的字幕,提供多种字幕分割选项:
- 句子级别:按句子分割字幕
- 词汇级别:1-3个单词为一个字幕条目
- 自定义分割:用户可以配置最大词数
- 多种格式:支持SRT、ASS等字幕格式
3. 高级语音定制
语音混合器功能
通过语音混合器,用户可以通过混合不同的语音模型来创建自定义语音,调整每个语音的权重并保存为配置文件以供将来使用。这个功能展示了Kokoro模型的灵活性:
# 语音混合的概念实现
def create_custom_voice(voice_models, weights):
    """
    创建自定义语音配置
    voice_models: 选择的语音模型列表
    weights: 各模型的权重
    """
    custom_voice = {}
    for i, model in enumerate(voice_models):
        custom_voice[model] = weights[i]
    return custom_voice
4. 章节处理与元数据
智能章节识别
Abogen能够自动识别ePub和PDF中的章节,并支持用户手动添加章节标记:
<<CHAPTER_MARKER:第一章 引言>>
这是第一章的内容...

<<CHAPTER_MARKER:第二章 主要内容>>
这是第二章的内容...
元数据支持
对于M4B格式的音频书,Abogen支持完整的元数据:
<<METADATA_TITLE:书名>>
<<METADATA_ARTIST:作者>>
<<METADATA_ALBUM:专辑名>>
<<METADATA_YEAR:出版年份>>
<<METADATA_GENRE:有声书>>
性能优化:Kokoro在实际应用中的表现
速度与质量的双重优势
在实际演示中,abogen在一台配备低端RTX 2060 Mobile GPU的笔记本上,仅用11秒就处理了约3000个字符的文本,生成了3分28秒的音频。这个表现充分证明了Kokoro-82M的效率优势:
性能指标对比:
- 处理速度:约273字符/秒
- 音频生成比:约19:1(19秒音频用时1秒生成)
- 资源消耗:在中低端GPU上流畅运行
硬件兼容性
Abogen展示了Kokoro-82M优秀的硬件适应性:
GPU支持:
- NVIDIA GPU:完整CUDA支持,最佳性能
- AMD GPU:通过ROCm支持(Linux环境)
- CPU模式:在没有GPU的环境下仍能运行
跨平台支持:
- Windows:一键安装包,自动处理依赖
- macOS:通过Homebrew简单安装
- Linux:全面支持,包括Docker部署
实际应用场景
1. 内容创作者的福音
有声书制作
Abogen使独立作者能够轻松将电子书转换为有声书,极大降低了有声内容制作的门槛:
# 简单的命令行使用
abogen input.epub --voice af_sarah --speed 1.2 --format mp3
多媒体内容
- YouTube视频:为视频内容添加高质量配音
- 播客制作:将文章转换为播客音频
- 社交媒体:为Instagram、TikTok等平台创建音频内容
2. 教育与无障碍应用
学习辅助
- 语言学习:多语言语音帮助学习发音
- 阅读困难支持:为有阅读障碍的用户提供音频替代
- 视觉障碍辅助:将文本内容转换为音频
3. 企业级应用
自动化内容生产
abogen提供了完整的API和批处理能力,适合企业级部署:
# 批量处理示例
import abogen

processor = abogen.BatchProcessor(
    voice='af_bella',
    speed=1.0,
    output_format='mp3',
    enable_subtitles=True
)

# 批量处理文档列表
results = processor.process_batch([
    'document1.pdf',
    'document2.epub',
    'document3.txt'
])
技术创新点分析
1. 实时字幕生成
Abogen能够生成与音频完美同步的字幕,这得益于Kokoro提供的时间戳标记功能。但目前这个功能仅支持英语,因为Kokoro只为英语文本提供时间戳标记。
2. 模块化架构设计
Abogen采用了高度模块化的设计,使得:
- 引擎替换:理论上可以替换为其他TTS引擎
- 功能扩展:易于添加新的输入/输出格式
- 定制开发:开发者可以基于abogen构建自己的应用
3. 用户体验优化
图形界面设计
Abogen提供了直观的图形用户界面,支持拖拽操作:
- 拖放文件即可开始处理
- 实时预览音频效果
- 可视化的语音混合器
- 详细的进度显示
配置管理
- 配置文件持久化
- 预设方案保存
- 一键恢复默认设置
部署与扩展
Docker容器化部署
Abogen提供了完整的Docker支持,便于在服务器环境中部署:
# 构建镜像
docker build --progress plain -t abogen .

# 运行容器(支持GPU加速)
docker run --name abogen -v $(pwd):/shared -p 5800:5800 --gpus all abogen
容器特性:
- 通过Web浏览器访问(端口5800)
- VNC客户端访问(端口5900)
- 文件共享目录(/shared)
- GPU加速支持
API集成
对于开发者,abogen提供了Python API:
from abogen import TextToSpeech

# 初始化TTS引擎
tts = TextToSpeech(
    model='kokoro-82m',
    voice='af_sarah',
    device='cuda'
)

# 转换文本
audio_data = tts.convert_text(
    text="Hello, this is a test.",
    output_format='wav',
    enable_subtitles=True
)
性能优化技巧
1. 硬件配置建议
最优配置:
- GPU:NVIDIA RTX 3060或更高
- 内存:16GB RAM
- 存储:SSD存储,至少10GB可用空间
最低配置:
- CPU:任何现代CPU(支持CPU模式)
- 内存:8GB RAM
- 存储:5GB可用空间
2. 批处理优化
对于大量文档处理:
# 优化批处理设置
config = {
    'batch_size': 10,  # 每批处理文档数
    'max_workers': 4,  # 并行工作线程
    'cache_enabled': True,  # 启用模型缓存
    'memory_limit': '8GB'  # 内存使用限制
}
3. 质量调优
语音质量优化:
- 选择合适的语音模型组合
- 调整语速和音调参数
- 使用语音混合器创建自定义音色
字幕同步优化:
- 根据内容类型选择合适的分割策略
- 调整最大词数限制
- 优化句子断点检测
社区贡献与生态
开源协作模式
Abogen项目欢迎社区贡献,提供了完整的开发指南:
# 开发环境搭建
git clone https://github.com/denizsafak/abogen.git
cd abogen
pip install -e .  # 可编辑模式安装
python -m build   # 构建包
相关项目生态
Abogen与其他开源项目形成了良好的生态:
- audiblez:电子书转有声书工具
- epub_to_audiobook:专注ePub转换
- pdf-narrator:PDF文档朗读工具
这些项目的存在证明了TTS技术在实际应用中的巨大需求。
未来发展方向
技术路线图
Abogen的未来发展计划包括:
- OCR集成:使用docling添加PDF OCR扫描功能
- 多语言GUI:支持不同语言的用户界面
- 语音克隆:集成语音克隆技术
- 暗色主题:提供暗色模式UI
- ONNX支持:集成kokoro-onnx以提高推理效率
商业化考虑
虽然abogen是开源项目,但它为商业应用提供了良好的基础:
- SaaS服务:基于abogen构建云端TTS服务
- 企业定制:为企业客户提供定制化解决方案
- 嵌入式应用:集成到其他商业软件中
实战指南:从零开始使用
快速开始
Windows用户:
- 下载并安装espeak-ng
- 运行WINDOWS_INSTALL.bat自动安装脚本
- 双击桌面快捷方式启动abogen
Linux/macOS用户:
# 安装依赖
sudo apt install espeak-ng  # Ubuntu
brew install espeak-ng      # macOS

# 安装abogen
pip install abogen

# 启动应用
abogen
第一个项目
- 准备文件:选择一个ePub或PDF文件
- 拖拽导入:将文件拖入abogen界面
- 选择语音:从美式英语或英式英语中选择喜欢的声音
- 配置设置:调整语速、字幕格式等参数
- 开始转换:点击"Start"按钮开始处理
- 预览效果:使用MPV等播放器预览结果
高级使用技巧
自定义语音配置:
# 创建语音混合配置
voice_mix = {
    'af_sarah': 0.6,   # 60%的Sarah音色
    'af_bella': 0.4    # 40%的Bella音色
}
批量处理脚本:
#!/bin/bash
# 批量处理目录中的所有ePub文件
for file in *.epub; do
    abogen-cli "$file" --voice af_nicole --speed 1.1 --format mp3
done
总结:开源TTS的完美范例
Kokoro-82M与abogen的结合,为我们展示了一个完美的开源AI应用案例。这个组合不仅技术先进,更重要的是它真正解决了用户的实际需求。
技术价值:
- 证明了轻量级模型的实用性
- 展示了开源协作的力量
- 推动了TTS技术的普及
社会价值:
- 降低了音频内容制作门槛
- 改善了视觉障碍人群的信息获取体验
- 促进了知识的无障碍传播
商业价值:
- 为创业者提供了低成本的TTS解决方案
- 为企业节省了语音服务费用
- 创造了新的商业模式可能性
通过abogen这个项目,我们看到了Kokoro-82M不仅仅是一个技术演示,而是一个真正可以改变人们生活的实用工具。这种将先进AI技术与用户需求完美结合的方式,或许就是开源AI项目应该追求的最高境界。
在AI技术快速发展的今天,像Kokoro-82M和abogen这样的项目提醒我们:技术的真正价值不在于参数的多少,而在于能够多大程度上解决现实问题,改善人们的生活质量。这正是开源精神的最佳体现——让先进技术服务于每一个人。


